
Este artículo es una colaboración entre MIT Technology Review y Aventine, una fundación de investigación sin ánimo de lucro que crea y apoya contenidos sobre cómo la tecnología y la ciencia están cambiando nuestra forma de vivir.
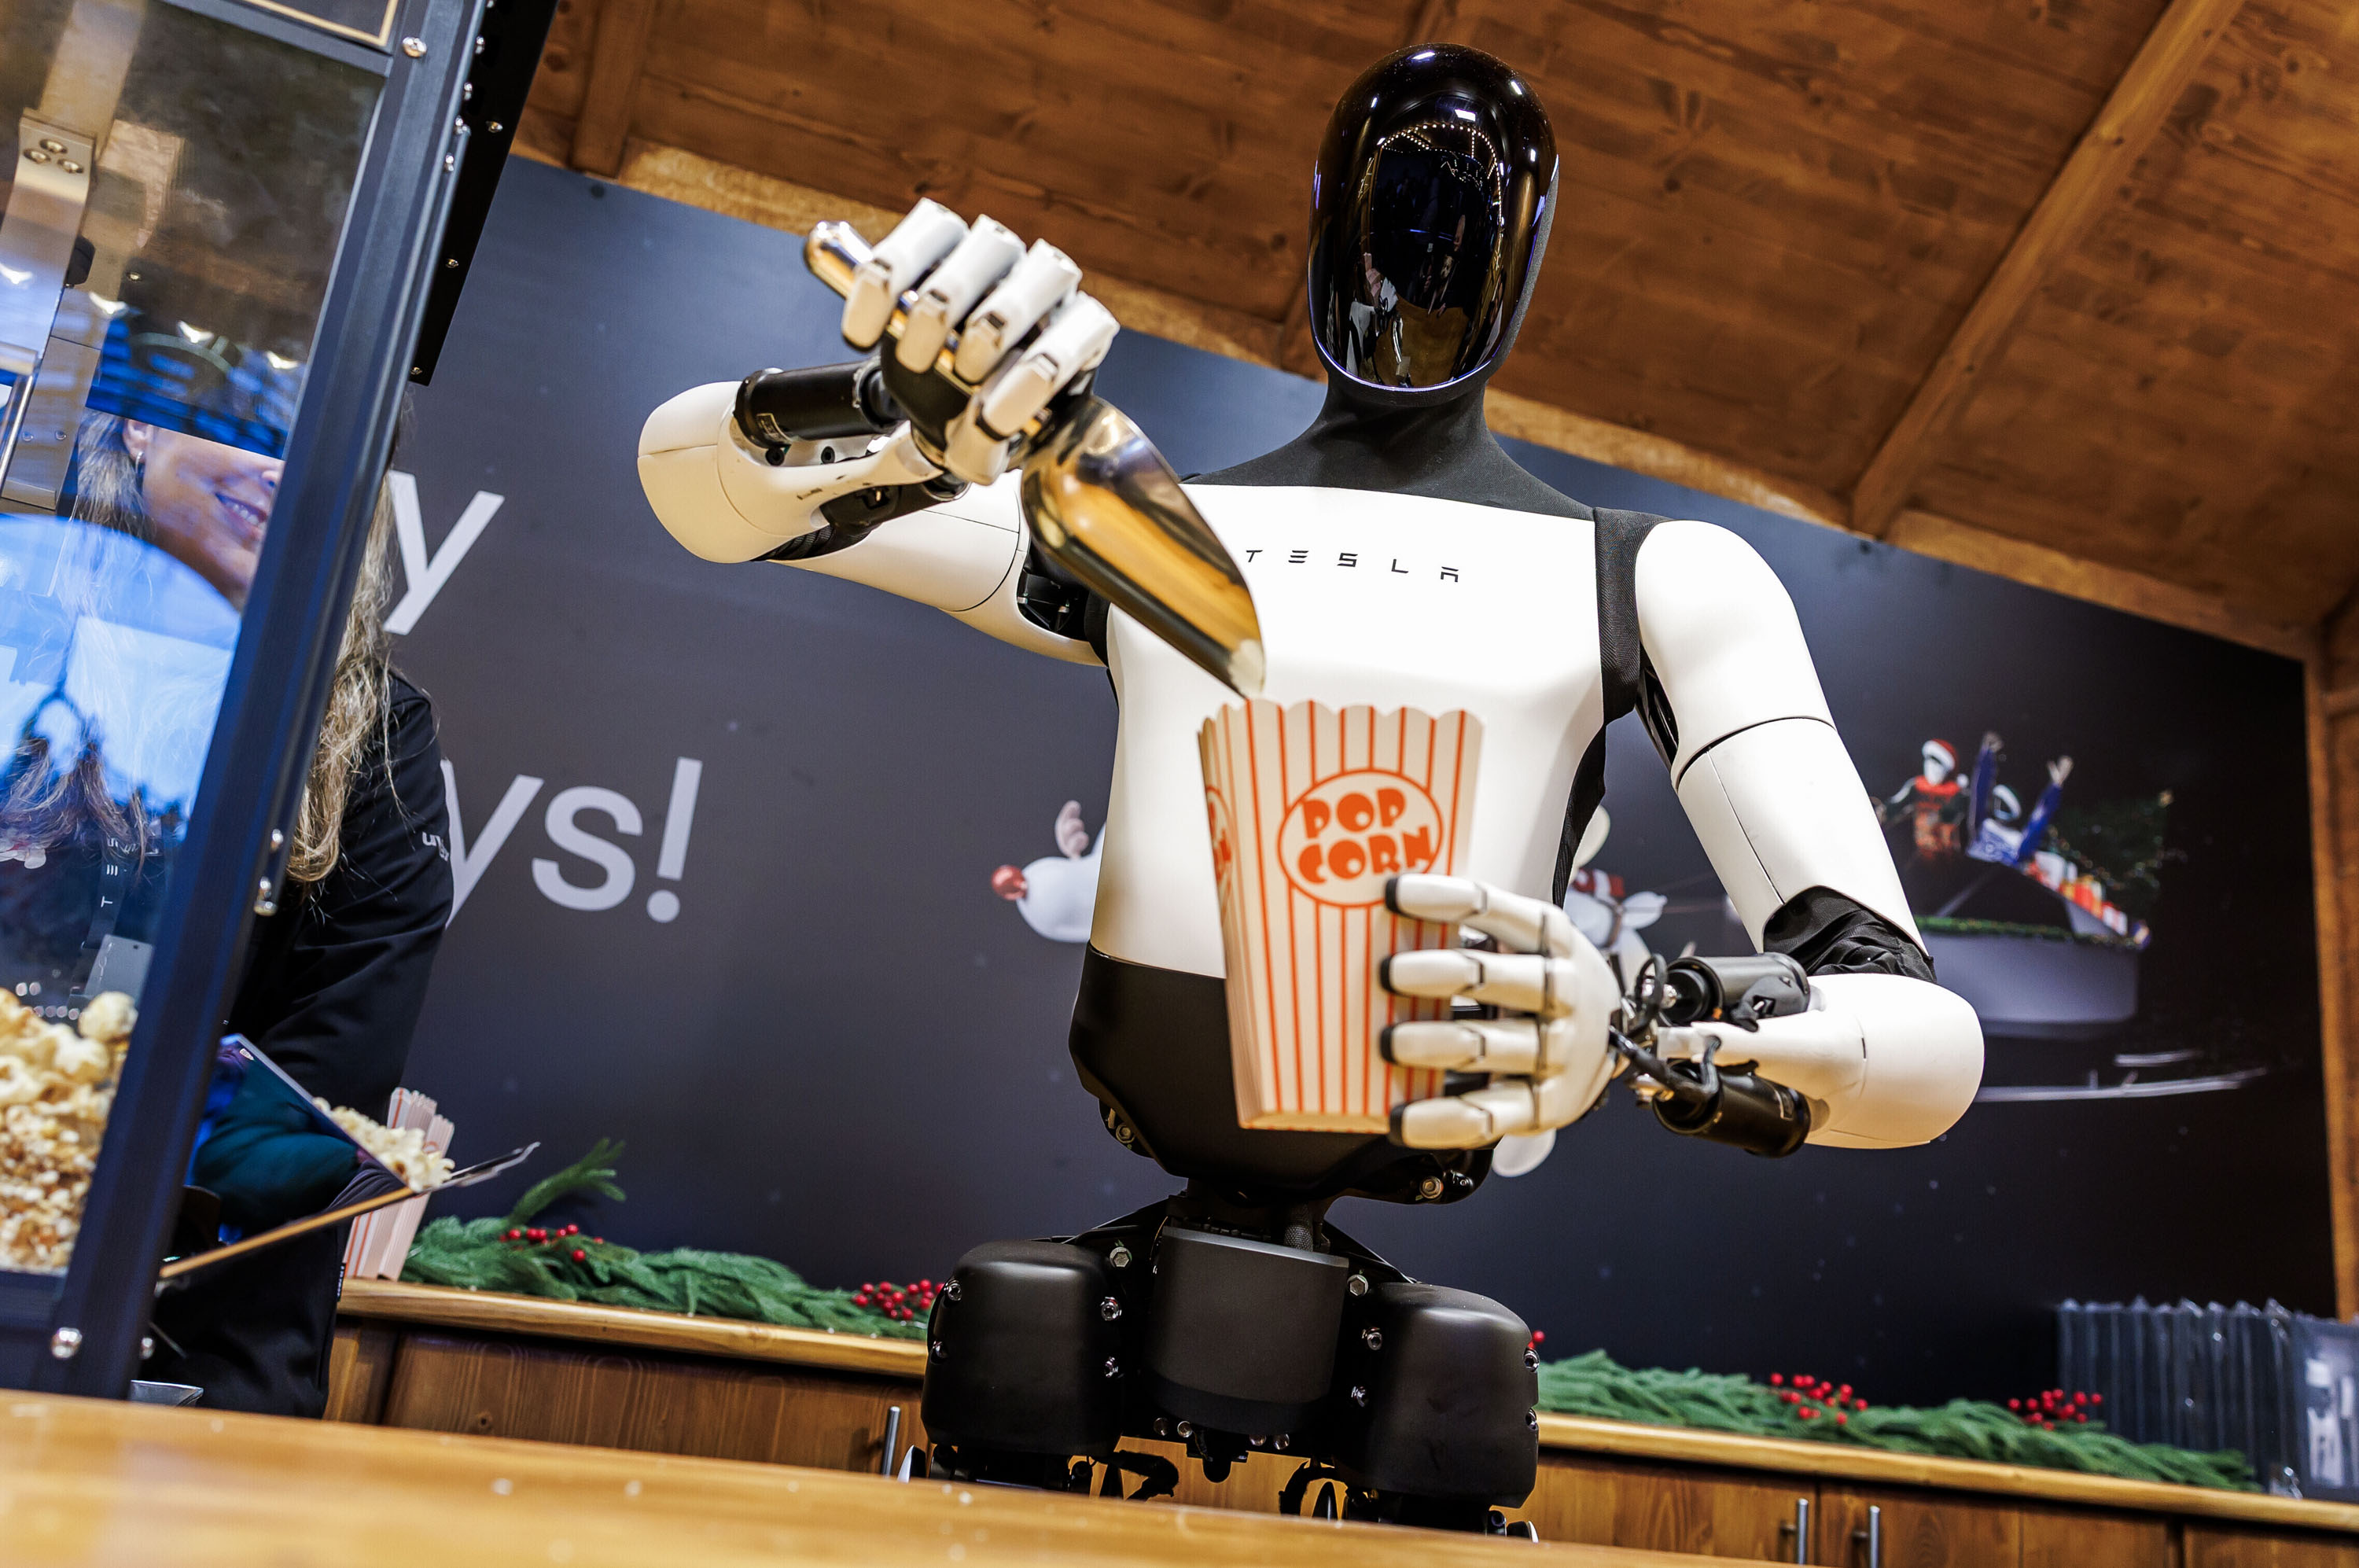
Un robot con forma humana —blanco, con la cabeza y el torso negros— ha estado apareciendo en los feeds de vídeo. Quizá lo hayas visto bailar o pasar palomitas, tirar basura a un cubo, pasar la aspiradora o pulsar el botón de un microondas. O tal vez lo hayas visto caerse de espaldas mientras repartía botellas de agua o tener dificultades para planchar una camisa.
Este sería Optimus, de Tesla, un robot humanoide impulsado por IA que, según Elon Musk, CEO de la compañía, será «no solo el producto más importante de Tesla de todos los tiempos, sino probablemente el mayor producto de la historia», destinado a trabajar en las fábricas y, más adelante, en nuestros hogares. Con el tiempo, «tendrá una destreza humana y, después, sobrehumana», aseguró a los accionistas en julio. Los robots Optimus podrían automatizar casi todo el trabajo humano —desde transportar planchas de metal hasta doblar la colada— por tan solo 20.000 dólares cada uno, sostiene Musk. Durante su intervención en la reunión anual del Foro Económico Mundial en Davos (Suiza) en enero, predijo que podrían estar a la venta para el público a finales de 2027.
Musk no está solo en su labor evangelizadora. Marc Andreessen, cofundador y socio general de la firma de capital riesgo de Silicon Valley Andreessen Horowitz, ha afirmado que la robótica podría convertirse en la «mayor industria de la historia del planeta». En enero, Jensen Huang, CEO de Nvidia, aseguró que los robots humanoides alcanzarían capacidades de nivel humano este año. Según Morgan Stanley, es probable que la cifra de robots que «se parecen y actúan como humanos» roce los mil millones para 2050, lo que generaría un mercado de más de cinco billones de dólares.
Estas afirmaciones están impulsadas en gran medida por la idea de que los mismos avances en IA que sustentan herramientas como ChatGPT de OpenAI y Claude de Anthropic permitirán que una nueva generación de robots imite el movimiento humano del mismo modo que los chatbots imitan el lenguaje humano. Sin embargo, muchos investigadores en robótica se muestran escépticos y sostienen que tales suposiciones minimizan el reto que supone utilizar una inteligencia construida a partir del lenguaje y las imágenes para dominar la infinita variabilidad del mundo físico. «Ninguna de esas empresas [que fabrican robots humanoides] —absolutamente ninguna— tiene la menor idea de cómo hacer que esos robots sean lo bastante inteligentes como para resultar útiles», afirmó Yann LeCun, a menudo considerado uno de los padrinos de la IA, en otro evento durante la conferencia de Davos de enero.
Los investigadores también señalan que la tendencia a confundir los robots humanoides diseñados para parecerse a las personas con las llamadas máquinas generalistas, capaces de aprender y realizar múltiples tareas, resulta engañosa. «Es muy fácil hacer un robot que se parezca a una persona», explica Jonathan Hurst, cofundador y director de robótica de Agility Robotics y profesor de Robótica en la Universidad Estatal de Oregón. «Es muchísimo más difícil crear una máquina que se mueva o se comporte de forma dinámica o física como una persona».
Estas tensiones —sobre si los robots humanoides polivalentes están a la vuelta de la esquina o si aún no se vislumbran, y sobre si las formas actuales de IA son todo lo necesario para perfeccionarlos— se están viviendo en los laboratorios de robótica de todo el país, donde las expectativas desmedidas en torno a los plazos están eclipsando un progreso minucioso pero significativo.
Hace aproximadamente una década, una serie de avances propició una revolución de la IA generativa que convirtió en realidad la largamente imaginada posibilidad de la inteligencia artificial. Los expertos en robótica —aunque discrepan sobre cuándo ocurrirá exactamente— creen que es posible una revolución igual de transformadora en este campo, una que dote a las máquinas de una intuición física y una fluidez que durante mucho tiempo han estado fuera de su alcance. A medida que el progreso en robótica avanza a paso lento, la cuestión es si los mismos métodos y herramientas que impulsaron los avances de la IA bastan para llegar hasta ahí, o si se requiere un camino completamente nuevo.
Los robots se encuentran con la IA avanzada
Para ver uno de los cerebros robóticos más inteligentes que funcionan en la actualidad, merece la pena fijarse en lo que Google DeepMind es capaz de hacer con un equipo llamado ALOHA 2, acrónimo de «A Low-cost Open-source Hardware System for Bimanual Teleoperation».
Los expertos en robótica llevan mucho tiempo enfrentados sobre si una forma humanoide es necesaria para los robots generalistas: sus defensores sostienen que les ayudará a integrarse en el mundo tal y como es, mientras que sus detractores afirman que no merece la pena la molestia. ALOHA 2 refleja esta segunda forma de pensar. A simple vista no parece gran cosa: tan solo es un par de brazos, unas pinzas y dos cámaras. Sin embargo, a pesar de su aparente sencillez, es un auténtico caballo de batalla para los investigadores de Google DeepMind, que lo utilizan en sus diversos laboratorios para poner a prueba su sistema de IA para robótica más avanzado, Gemini Robotics.
Bajo el control de Gemini Robotics, ALOHA 2 se convierte en un robot más generalista, en el sentido de que puede realizar multitud de tareas a partir de los ejemplos con los que ha sido entrenado. Pídele que prepare una fiambrera y, tal y como muestra un vídeo de este ejercicio, puede utilizar dos pinzas para meter con delicadeza una rebanada de pan de molde en una bolsa Ziploc, cerrarla, colocar un racimo de uvas en un recipiente de Tupperware, encajar la tapa y, a continuación, guardar con cuidado los elementos en una fiambrera antes de cerrarle la cremallera.
No es un gran almuerzo. Pero el hecho de que el robot sea capaz de prepararlo representa un avance objetivo con respecto a lo que era posible hace, digamos, apenas tres años.
Esto se debe en gran medida a la IA y a su impacto en lo que se conoce como políticas robóticas, que controlan cómo un robot de propósito general debe evaluar y comprender su entorno, planificar cómo moverse por él y, después, ejecutar su tarea correctamente.
El robot ALOHA 2 no es mucho más que dos brazos mecánicos sobre una mesa de trabajo, pero sirve como banco de pruebas para modelos de IA robótica de vanguardia. Estas animaciones se basan en la teleoperación humana de los brazos robóticos, datos que se utilizan para entrenar los modelos de Google DeepMind. (Vídeo: Google DeepMind / Stanford University / Hoku Labs)
Históricamente, estas políticas se basaban en reglas desarrolladas por ingenieros que las programaban directamente en el software del robot: miles de líneas de código que determinaban cada milímetro de los movimientos del robot en cientos de tareas. Lo que ha estado ocurriendo durante los últimos años —y lo que explica en gran medida el optimismo respecto a los robots generalistas— es que las políticas de los robots se están delegando en sistemas avanzados de IA en lugar de programarse en su software. Esto ocurrió primero con los VLM, o modelos de visión y lenguaje. Son similares a los grandes modelos de lenguaje, pero están entrenados tanto con imágenes como con palabras. Muéstrale a un VLM una imagen de un café derramado y pídele que busque una herramienta para limpiar el estropicio, y será capaz de identificar un trapo cercano. Este tipo de comprensión contextual inmediata no existía hace un par de años, cuando las políticas de los robots se programaban manualmente.
Después llegaron los modelos de visión-lenguaje-acción, que permiten a los robots evaluar su entorno y actuar en él. Estos modelos lo consiguen añadiendo un componente más: órdenes de movimiento. Los VLA se entrenan con una serie de imágenes o vídeos relacionados con la realización de una tarea determinada, junto con datos asociados sobre cómo se mueve un brazo robótico para llevarla a cabo. Esos datos de movimiento suelen recopilarse mediante teleoperación, en la que un humano utiliza controles remotos para guiar al robot a lo largo de una acción. Este tipo de entrenamiento permite a la IA aprender a ordenar al robot cómo moverse y operar durante una tarea específica. Coloca a un robot basado en VLA frente a un escritorio y dile «cierra el portátil» o «enrolla el cable de los auriculares», y examinará la escena, identificará el objeto pertinente, planificará una forma de ejecutar la petición y pondrá sus brazos en acción —al menos si ya ha visto realizar esta tarea antes—.
El modelo Gemini Robotics es un VLA, entrenado a partir de muchas horas de demostraciones humanas que muestran una amplísima variedad de acciones distintas. Como resultado, puede realizar tareas relativamente complejas como coger tirabeques con unas pinzas de cocina, hacer papiroflexia o preparar un almuerzo sencillo. Es impresionante, pero existe una limitación flagrante: por ahora, si a un robot controlado por un VLA se le pide realizar una tarea que queda fuera de su conjunto de entrenamiento, es muy probable que falle.
«Si pensamos en el espacio de todas las tareas, una política verdaderamente generalista sería capaz de hacer cualquier cosa a lo largo de ese espectro», afirma Edward Johns, profesor de Robótica en el Imperial College de Londres. Hoy en día, sin embargo, un modelo de Gemini Robotics solo puede hacer «algunas cosas aquí y otras allá».
La búsqueda de la verdadera generalidad
Entonces, ¿cómo conseguimos que los robots puedan hacer más cosas? La respuesta habitual probablemente no sorprenda: entrenándolos con más datos.
Más datos, según esta lógica, equivalen a más ejemplos, y más ejemplos equivalen a una mayor generalización. Google DeepMind, por ejemplo, quiere recopilar «tantos datos como sea posible», afirma Pannag Sanketi, antiguo responsable técnico de robótica en la empresa que actualmente trabaja en su propio proyecto de robótica con IA. Pero ¿de dónde sacarlos? Los grandes modelos de lenguaje contaban con la ventaja de disponer de océanos de texto existente para su entrenamiento. No hay un repertorio equivalente de demostraciones físicas de alta calidad con el que entrenar a los robots. Los investigadores cuentan con varias formas de compensar esto, pero todas tienen sus fallos. Una consiste en emplear a un gran número de personas para generar y recopilar datos de teleoperación (algo costoso y lento). Otra es entrenar modelos VLA con vídeos de personas realizando actividades (la calidad de los datos resultantes es deficiente). Otra alternativa es desplegar robots en el mundo real y utilizar los datos recogidos de esas experiencias para perfeccionar aún más los modelos de IA (los robots no son seguros ni fiables fuera de los laboratorios). Sanketi cree que un enfoque «en varios frentes» que utilice datos recopilados de todas estas fuentes es el camino más probable a seguir.
Sin embargo, la creencia de que los datos de entrenamiento por sí solos son la solución dista mucho de ser universal. Hurst, de Agility, la describe como «una premisa fundamentalmente errónea».
El problema es que las tareas en el mundo real disparan rápidamente su complejidad. Si intentas, por ejemplo, preparar café, intervienen infinidad de variables: no hay dos cocinas idénticas; las cafeteras funcionan de formas distintas; las diferentes tazas exigen agarres diferentes; el café molido, el agua caliente y la leche deben manipularse de forma distinta. Incluso una tarea tan simple como esta requiere comprender un abanico de posibilidades en constante cambio. Lograr la generalización a través de los VLA, sostiene Hurst, exigiría «una cobertura total de datos de todas las cosas que [un robot] podría llegar a hacer». O, en otras palabras, un volumen casi infinito de datos de entrenamiento.
LeCun rechaza de pleno este enfoque. «Los enfoques [de IA] que han tenido éxito con el lenguaje no funcionan para datos de alta dimensionalidad, continuos y ruidosos» —el tipo de datos habitual en robótica, afirmó en Davos—. «Hay que utilizar otra cosa».
El principal candidato para esa «otra cosa» es el denominado modelo de mundo: una forma de IA entrenada menos con texto que con una combinación de vídeo, escaneos tridimensionales y datos de sensores, diseñada para predecir las consecuencias de las acciones en el mundo real. El objetivo es crear modelos que posean una representación interna de la realidad lo bastante precisa como para captar cómo funciona verdaderamente el mundo físico: cómo se mueven los objetos, colisionan, caen y se deforman. Si los expertos en robótica pudieran entrenar a las máquinas en simulaciones lo suficientemente fieles a la física del mundo real, el desarrollo sería más rápido, más económico y más seguro, lo que reduciría la necesidad de realizar pruebas en el entorno real. Algo aún más transformador: los robots equipados con modelos de mundo podrían razonar sobre su entorno en lugar de limitarse a reaccionar ante él, lo que les ayudaría a anticipar las consecuencias de una acción antes de llevarla a cabo.
Empresas como Nvidia y Google están trabajando en esta tecnología, y el dinero de los inversores llega a raudales a empresas emergentes de renombre. World Labs, cofundada por la investigadora de IA de Stanford Fei-Fei Li, captó 1000 millones de dólares de financiación en febrero y fue adquirida por AMD a finales de septiembre por 8200 millones de dólares. AMI Labs, cofundada por LeCun (anteriormente científico jefe de IA en Meta), también captó 1000 millones de dólares en marzo. Sin embargo, según admiten ellos mismos, aún es muy pronto. A finales del año pasado, Li describió este campo como «incipiente», y añadió que «los enfoques fundamentales aún se están estableciendo». En un artículo de Substack en junio, describió desafíos abrumadores. Por ahora, los modelos de mundo son un área de investigación prometedora más que una vía inmediata hacia la robótica de propósito general, pero estamos empezando a vislumbrar destellos de lo que podrían llegar a conseguir.
Uno de esos atisbos llegó con un avance pequeño pero potencialmente significativo que tuvo lugar en un laboratorio de robótica de San Francisco el pasado mes de abril.
¿Un gran avance?
En pleno corazón del Mission District de San Francisco, la startup Physical Intelligence —o PI (como π), como le gusta que la conozcan— se centra en desarrollar un cerebro universal que, en teoría, podría convertir a cualquier robot en un generalista. Con un enfoque que lo incluye absolutamente todo a la hora de entrenar modelos de IA para robots, la empresa observó recientemente un atisbo de lo que podría ser capaz un cerebro robótico equipado con un modelo del mundo.
En 2024, PI publicó detalles de su primer sistema robótico generalista, bautizado como π0, un VLA que, según afirmaba la empresa, era la «política robótica generalista más capaz y diestra hasta la fecha». El modelo se entrenó inicialmente con una colección propia de 10.000 horas de demostraciones humanas recopiladas mediante teleoperación, así como con varios conjuntos de datos robóticos de código abierto. Una versión lanzada en la primavera de 2025, π0.5, se entrenó con una variedad más amplia de conjuntos de datos, incluidas imágenes etiquetadas de la web, lo que le aportó una mayor versatilidad. Una actualización en otoño de 2025, π0.6, añadió aprendizaje por refuerzo al modelo.
Cada actualización aportó mejoras importantes al rendimiento del modelo, ampliando su repertorio de habilidades: desde doblar la colada lentamente hasta ordenar objetos en nuevos entornos o completar tareas como plegar cajas con una mayor tasa de éxito. Después, en abril de 2026, π0.7 pareció catapultar a PI a un nuevo territorio. Esta versión utiliza un modelo del mundo menos potente que genera imágenes de los pasos necesarios para llevar a cabo una tarea. A medida que el robot realiza el trabajo, este modelo «ligero» le suministra instantáneas de lo que debe hacer a continuación.
La empresa afirma que el modelo muestra los primeros indicios de generalización composicional, un término que hace referencia a la capacidad de los sistemas de IA para poner en práctica habilidades a las que nunca han estado expuestos, recombinando las aprendidas durante su entrenamiento. Una de las pruebas consistió en pedirle al modelo que «metiera un boniato en la freidora de aire», una tarea con la que jamás se había topado. En un vídeo de demostración, la máquina titubea un poco, hace un par de intentos en falso y finalmente logra un resultado razonable, aunque no termina la tarea por completo.
Sergey Levine, profesor de la Universidad de California en Berkeley y cofundador de PI, se muestra entusiasmado ante este potencial: «En realidad, es la primera vez que vemos de forma convincente ese tipo de generalización composicional, en la que básicamente podemos pedirle al modelo que realice tareas para las que no recopilamos datos específicamente ni lo entrenamos, y realmente hace un intento aceptable».
El éxito llevó al equipo a preguntarse cómo había sido capaz el modelo de lograr semejante hazaña. Tras indagar un poco, encontraron fragmentos relevantes de datos etiquetados de teleoperación ocultos en el material de entrenamiento, incluidos dos ejemplos de un operador humano utilizando el robot para introducir la cesta de una freidora de aire en el aparato. Esos retazos de datos podrían haber bastado para que π0.7 estuviera a punto de cocinar una batata en la freidora de aire.
Por ahora, no está del todo claro hasta qué punto es impresionante la capacidad de generalización de π0.7. Aun así, teniendo en cuenta lo fugaz que había sido la exposición del modelo a las freidoras de aire, ofrece una muestra de lo lejos que la investigación de vanguardia puede llevar a los robots en la actualidad.
«Un 70 % de éxito es como si no funcionara»
Quizá percibas cierta desconexión entre los vacilantes primeros pasos que dan los robots en los laboratorios —«¡Mira! ¡Ha metido un boniato en una freidora de aire!»— y la deslumbrante y realista agilidad que se aprecia en muchas demostraciones y vídeos, donde se ve a los robots haciendo de todo: desde bailar en un escenario hasta servir copas con cortesía. Estas demostraciones a menudo no revelan con claridad un dato clave: en muchos casos, hay personas controlando al robot o han preparado meticulosamente sus acciones siguiendo un guion. (El robot que apareció en el escenario junto al CEO de Nvidia, Jensen Huang, en marzo de 2025, por ejemplo, que parecía responder a sus instrucciones y seguirle a todas partes, estaba teledirigido por lo que sus creadores denominaron «un titiritero entre bambalinas»).
Por ahora, la planificación de movimientos totalmente autónoma para que un robot sepa adónde debe dirigirse —especialmente en entornos nuevos y caóticos, como una obra o un hogar desconocido— sigue siendo un reto en gran medida sin resolver. Un desafío aún mayor —aunque a menudo relacionado— reside en conseguir que los robots aborden tareas más amplias y ambiguas que engloban múltiples subtareas y exigen decidir cómo y en qué orden ejecutarlas. Esta sería la diferencia entre un robot capaz de meter un plato en el microondas y otro que pueda responder con éxito a la orden «Haz la cena» inspeccionando el frigorífico, picando los ingredientes y encendiendo los fogones. Los mejores intentos de Google DeepMind en este sentido —que consistieron en pedir a su robot que inspeccionara una cocina y metiera en una cesta todos los ingredientes para un risotto de setas— se han saldado de momento con un fracaso.
A esto se suma la dificultad de que un robot para uso práctico debe, en esencia, acertar siempre. Con los VLA, «la gente se entusiasma mucho cuando su resultado pasa del 50 % de éxito al 70 %», afirma Marc Raibert, fundador de Boston Dynamics. «Pero un 70 % de éxito es como si no funcionara, ¿verdad?».

Los pocos humanoides que se están probando en entornos reales llevan a cabo tareas sumamente limitadas en entornos estrictamente controlados. Están muy lejos de ser generalistas. Agility tiene cientos de robots desplegados en pruebas en instalaciones de GXO Logistics, Amazon y Schaeffler, según la empresa. Pero, por ahora, afirma Hurst, los robots se centran en tareas sencillas, como mover contenedores y cajas. Aun así, añade, hicieron falta años para desarrollar robots lo bastante seguros como para que las empresas de logística se plantearan siquiera utilizarlos. Por su parte, Elon Musk afirmó en mayo de 2025 que «miles» de sus robots Optimus estarían trabajando en las fábricas de Tesla para finales de año, pero en enero de este año dijo que la empresa solo contaba con «algunos de los robots Tesla Optimus realizando tareas sencillas en la fábrica».
Aunque los humanoides están empezando a adentrarse en las fábricas, dar el salto a los hogares será aún más difícil. Ahora mismo, si así lo deseas, puedes reservar el robot doméstico 1X Neo, cuya entrega está prevista para algún momento a finales de este año. Por 20.000 dólares, promete encargarse de «las tareas aburridas y mundanas de la casa» —recoger los platos, abrir la puerta, ordenar el salón— «para que puedas centrarte en lo que de verdad te importa». La idea es que este robot de 1,68 metros de altura realice algún día todas esas tareas de forma autónoma, pero por ahora se necesita un operador humano en remoto para casi todo. (Sí, una persona necesitaría permiso para asomarse a tu casa a través de las cámaras del robot). Al preguntarle cuánto falta para que los robots totalmente autónomos estén listos para las labores domésticas, Hurst afirmó: «Si tuviera que dar una cifra, diría que faltan diez años para que los robots estén... haciendo de verdad cosas útiles en las casas de la gente».
Cuando eso ocurra, es muy probable que los robots sean chinos, ya que China va muy por delante de Occidente en términos de producción. Casi el 90 % de los cerca de 15 000 robots humanoides distribuidos en 2025 fueron fabricados por empresas chinas, según la compañía de inteligencia de mercado Omdia y la firma china de robótica Unitree. Un modelo producido por Unitree, que distribuyó más robots humanoides que cualquier otra empresa el año pasado, cuesta menos de 6000 dólares. Un precio tan asequible podría contribuir enormemente a hacer que los robots resulten más atractivos para los consumidores, aunque la empresa prevé que sus máquinas se utilicen primero en aplicaciones industriales. (Por cierto, si te preguntas quién compra todos estos robots chinos, AP informó recientemente de que los pedidos proceden predominantemente de laboratorios corporativos y académicos y de empresas estatales).
Ya hemos pasado por esto
El sueño de construir un robot humanoide viene de lejos: ya en 1495, Leonardo da Vinci esbozó los diseños de un caballero mecánico controlado por cables y poleas. A lo largo del siglo XX, máquinas fruto de febriles sueños de ciencia ficción han ido y venido.
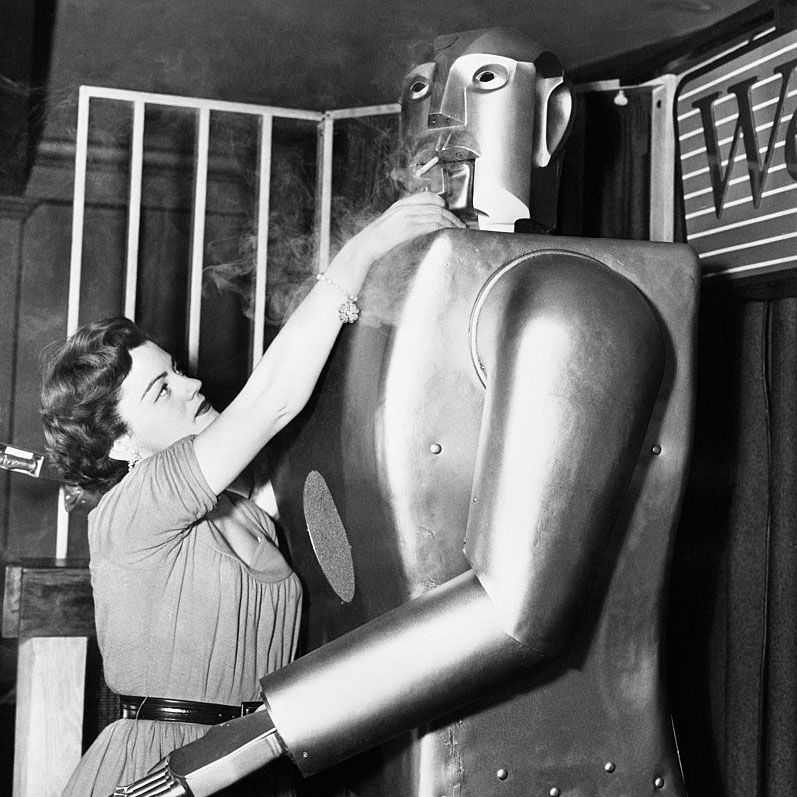
Elektro, la caja con patas de más de dos metros de altura desarrollada por Westinghouse, causó furor en la Feria Mundial de Nueva York de 1939 fumando un cigarrillo. WABOT-1, construido por la Universidad de Waseda en Japón en 1973, fue el primer robot humanoide programable a escala real. ASIMO, de Honda, presentado en el año 2000, fue probablemente la primera máquina de este tipo en demostrar cierta competencia: podía, al menos hasta cierto punto, subir escalones, reconocer rostros y desplazarse de forma autónoma por distintos espacios. Sin embargo, el robot se retiró en 2018, incapaz de avanzar más allá de lo que lograba en las demostraciones para llegar a ser útil.
Todos ellos, en su momento, fueron proezas de la ingeniería impresionantes —e incluso asombrosas—. Pero ninguno estaba preparado para desenvolverse en el mundo real. Los robots actuales, incluso con el poder transformador de la IA avanzada, siguen enfrentándose al mismo desafío existencial.