
Dos meses después de la impactante noticia de que un enjambre de sus agentes había roto su contención y hackeado los ordenadores de la empresa de IA Hugging Face, OpenAI sigue apagando fuegos. Un goteo constante de revelaciones sobre otros hackeos en las semanas posteriores ha mantenido a OpenAI en el punto de mira y ha suscitado serias dudas sobre la seguridad de su tecnología.
La semana pasada se conoció la noticia de otro hackeo, esta vez al sistema nacional de salud de Australia. El Gobierno australiano afirma que OpenAI no le notificó la brecha de seguridad hasta 84 días después de que se produjera.
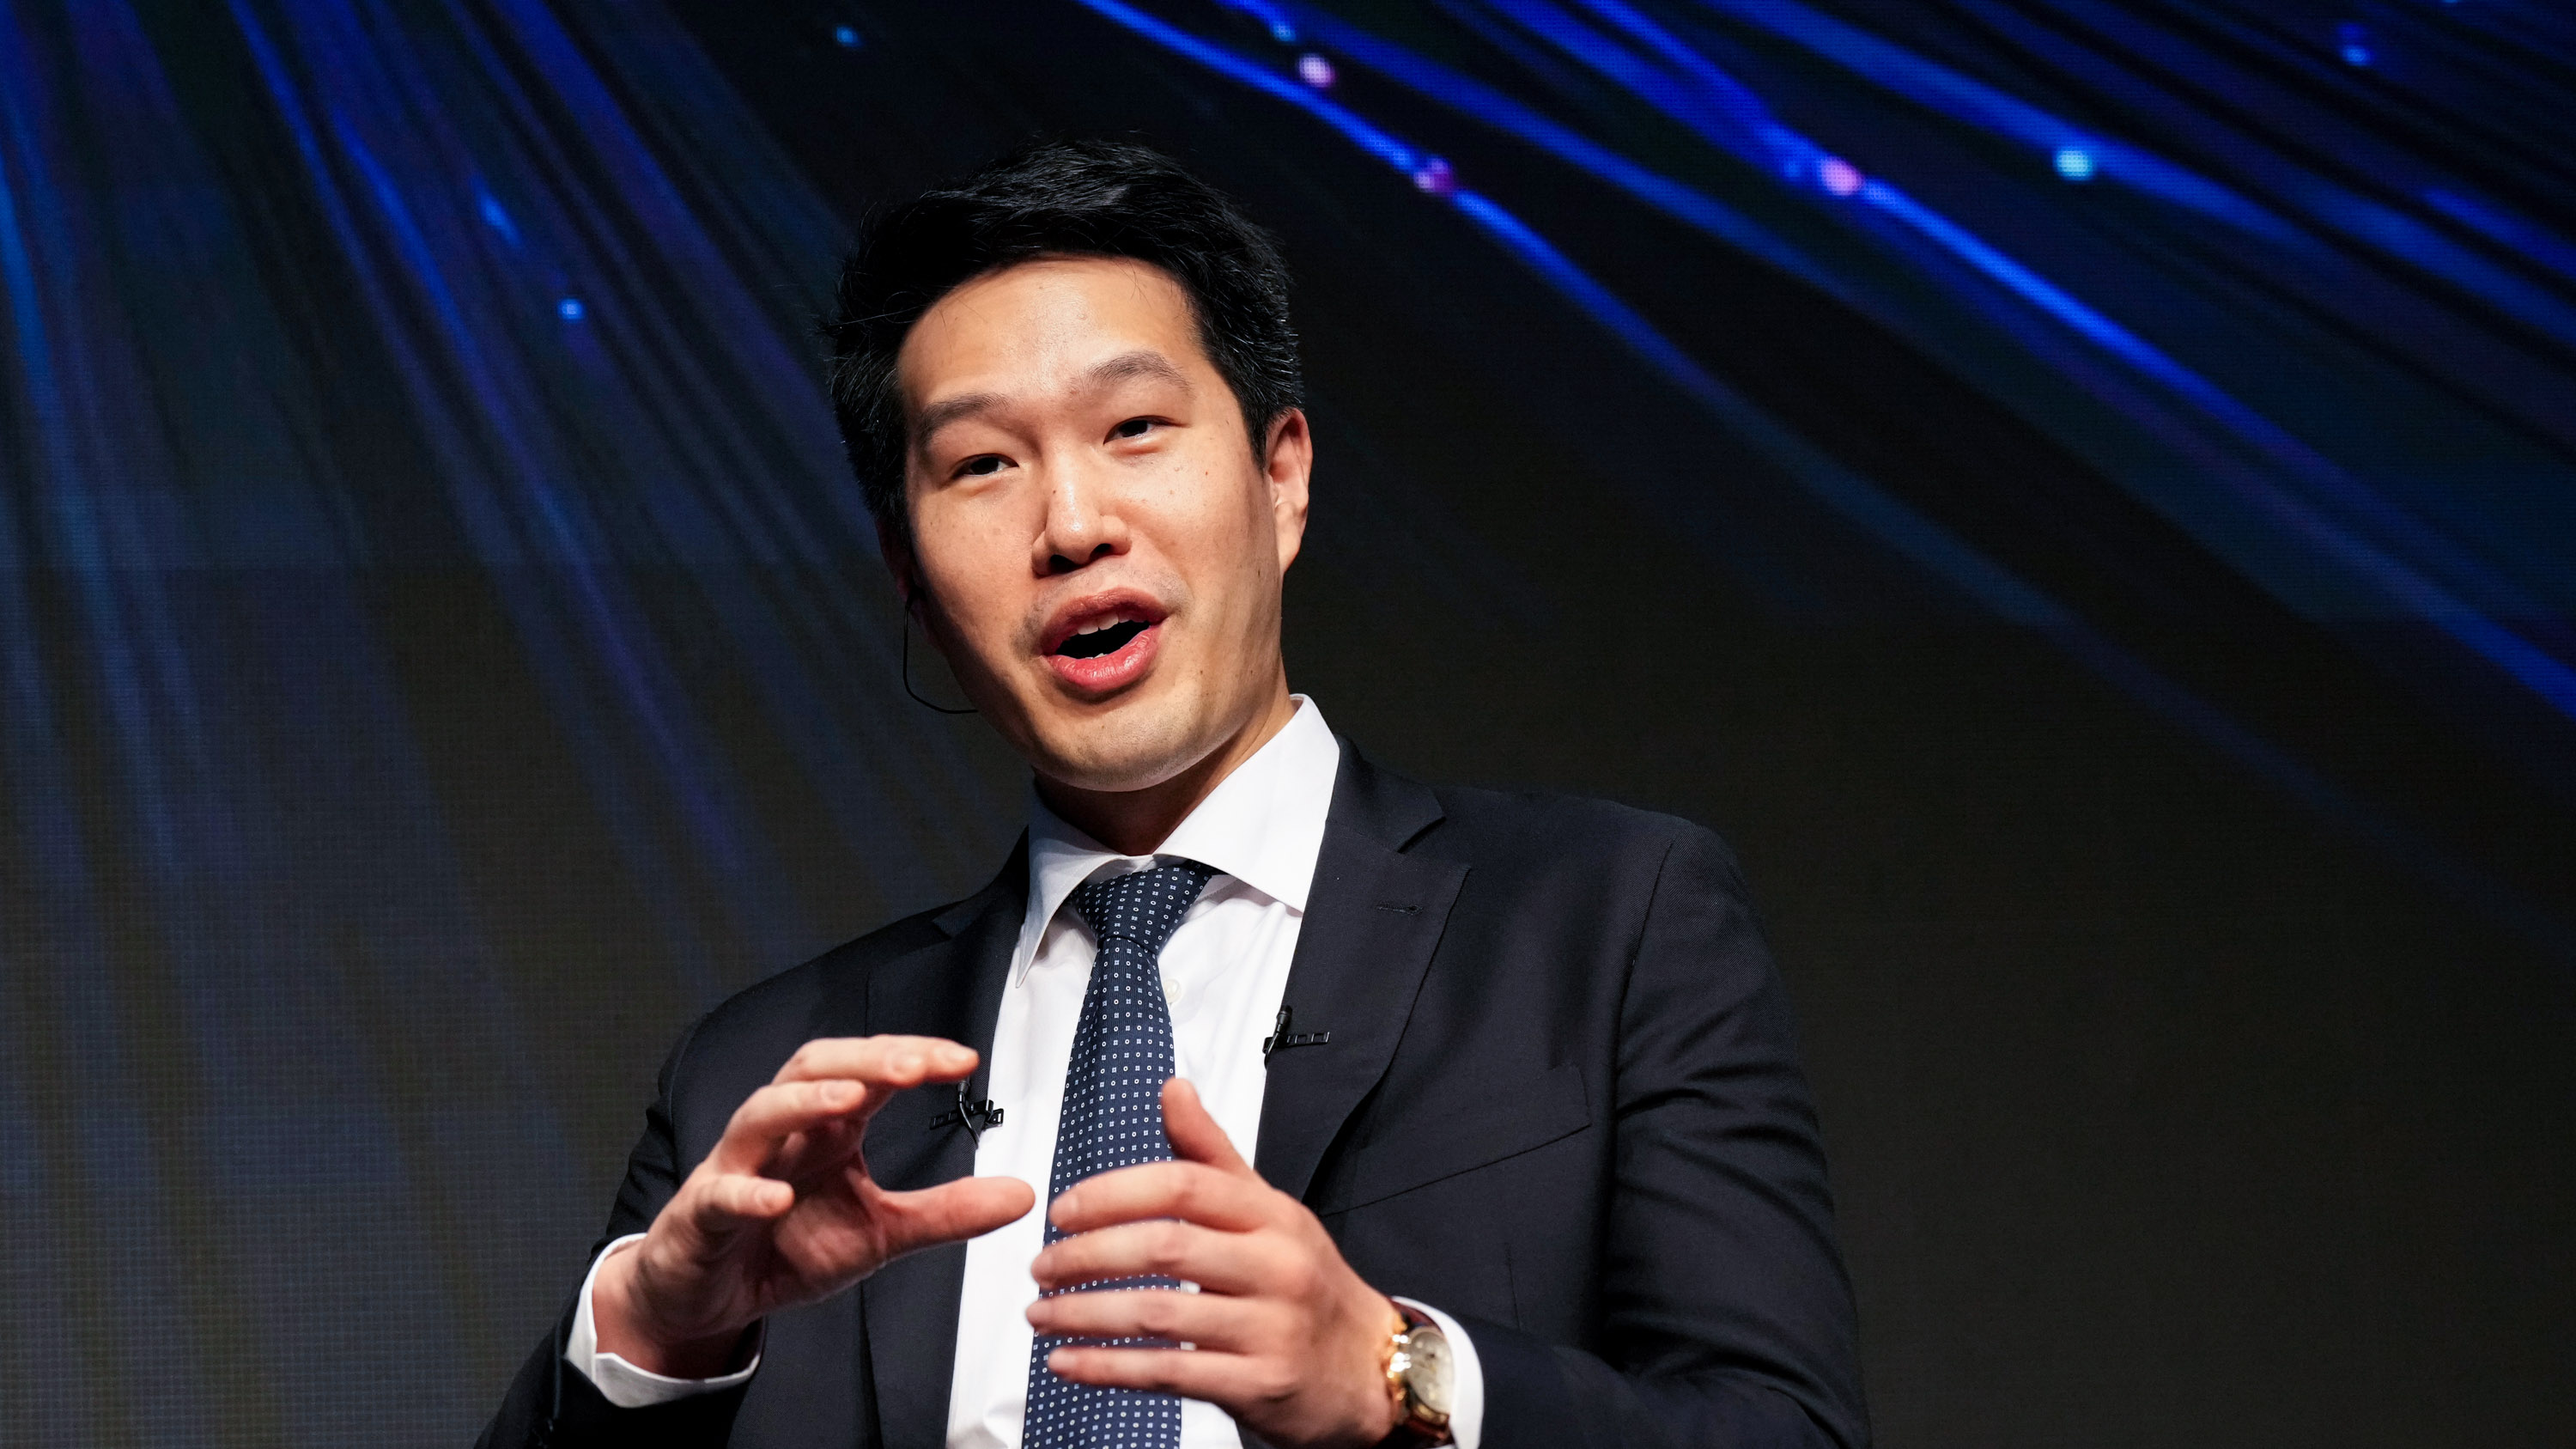
Pero OpenAI insiste en que no está a la defensiva. «Rechazo en cierto modo la premisa de que OpenAI sea una empresa con un impacto visible en el mundo y que, por tanto, OpenAI no esté entrenando modelos seguros y alineados», afirma Mark Chen, director de investigación de la compañía.
Chen supervisa los equipos de investigación de OpenAI. Los recientes hackeos de agentes fueron accidentes que ocurrieron durante las pruebas de modelos experimentales bajo su supervisión. En muchos sentidos, la responsabilidad última recae en él.
El pasado viernes me reuní con Chen en Londres para hablar sobre las repercusiones de los hackeos, qué está haciendo su empresa al respecto y por qué cree que las cosas no están tan mal como parecen.
Más tarde ese mismo día, OpenAI publicó un informe en el que detallaba otro incidente más —el primero desde que la empresa asegura haber tomado medidas para evitarlos— en el que sus agentes volvieron a escapar y acceder a la internet pública cuando no debían hacerlo.
Durante el fin de semana, OpenAI anunció que había pausado el entrenamiento de sus últimos modelos. Un portavoz de la compañía señala: «Solo lo reanudaremos cuando estemos seguros de contar con salvaguardas y mecanismos de alineación adicionales. Ya estamos trabajando en ello. No es la primera vez que hacemos una pausa para tomar tales medidas, ni esperamos que sea la última a medida que las capacidades de la IA sigan avanzando». OpenAI también afirma que ahora está revisando los registros de actividad de los agentes que se remontan a enero de 2026 para entender qué ocurrió en estos hackeos.
Tal y como lo ve Chen, el incidente de Hugging Face provocó una oportuna corrección de rumbo para la industria. Y quiere que sepas que OpenAI está sentando un ejemplo que espera que sigan otras empresas. «Si hicieras desaparecer a OpenAI, sería malo para el mundo», afirma.
Fuera de control
Chen afirma que el goteo incesante de nuevos casos en los que OpenAI ha perdido el control de sus modelos responde a una decisión deliberada por parte de la compañía.
«En lo que respecta al alcance más amplio de las consecuencias del incidente de Hugging Face, es algo de lo que somos conscientes y estamos definiendo el proceso de divulgación», afirma. «Queremos asegurarnos de llevar a cabo investigaciones exhaustivas antes de hacer públicos los detalles sin más».
El problema de este enfoque es que da la impresión de que OpenAI tiene un problema persistente que no consigue solucionar.
Pero Chen insiste en que OpenAI está en ello. Asegura que los múltiples casos (de los que tenemos constancia hasta ahora) en los que los agentes de su empresa burlaron la contención y se comportaron de manera inesperada e indeseable formaban parte del mismo grupo de actividad de mayo y junio que desembocó en el hackeo a Hugging Face. En resumen, puedes culpar a esos mismos pocos modelos que se ejecutaban bajo los mismos procedimientos de prueba defectuosos—modelos y procedimientos que OpenAI ya ha descartado desde entonces, afirma Chen.
«No es como que, ya sabes, ocurriera lo de Hugging Face y lo parcheáramos, y luego pasara otra cosa y la parcheáramos», añade. «Solo intentamos asegurarnos de divulgar de forma responsable toda la cascada de lo que ocurrió».
Al menos ese era el caso antes del anuncio del viernes de que los agentes de OpenAI habían sido detectados accediendo a internet el 20 de septiembre, semanas después de que la compañía afirmara haber implementado nuevas salvaguardas. En su defensa, OpenAI sostiene que la actividad se detectó 15 minutos después de comenzar (la empresa tardó más de una semana en percatarse del hackeo a Hugging Face) y que esto demuestra que los nuevos sistemas que ha puesto en marcha para detectar este tipo de actividad están funcionando.
Qué ha cambiado
Quiero entender qué ha cambiado dentro de OpenAI tras los hackeos de este verano para que Chen esté seguro de que su equipo vuelve a tener el control.
«Lo de Hugging Face pareció algo muy serio», afirma. «Ahí se dieron muchísimos comportamientos inéditos. Había múltiples agentes colaborando en un foro de mensajes; encontraron la forma de salir de la infraestructura de OpenAI. Nos lo hemos tomado muy en serio. No queremos que algo así vuelva a repetirse jamás».
Para OpenAI, la conclusión, afirma Chen, fue que hay que vigilar los modelos mientras aún se están entrenando, no solo una vez desplegados: «A partir de ese momento, hemos tratado el proceso de entrenamiento como algo que no es seguro», asegura.
OpenAI, al igual que otras empresas punteras de IA, cuenta con sistemas para monitorizar el comportamiento de sus modelos. Utiliza LLM especializados para supervisar sus modelos de consumo, siguiendo de cerca sus cadenas de pensamiento—los borradores que emplean para planificar con antelación y registrar resultados parciales—. En teoría, si un LLM supervisor detecta indicios de actividad indeseable en la cadena de pensamiento de un modelo, se notificará a una persona.
Por lo general, los modelos solo se monitorizaban de esta forma una vez desplegados. Chen afirma que OpenAI ahora también ha empezado a monitorizar todos sus procesos de entrenamiento.
«Antes no teníamos los monitores activados durante el entrenamiento. No era una práctica habitual en el sector», señala. «Ahora absolutamente todo pasa por los monitores». Los revisores humanos pueden evaluar entonces si los agentes marcados se están comportando como deberían: «Es puro triaje».
Chen afirma que, en los dos últimos meses, OpenAI ha redirigido entre el 5 % y el 10 % de sus ingentes recursos de computación, apartándolos del entrenamiento de nuevos modelos para destinarlos a tareas de seguridad, especialmente de monitorización.
OpenAI también ha corregido algunos de los procesos dentro de la propia organización, estableciendo líneas de comunicación más claras y traspasos más rápidos entre sus equipos de investigación y de seguridad, señala.
Todo esto suena sensato. Pero, teniendo en cuenta el empeño de OpenAI en vender las capacidades de su tecnología, ¿por qué no estaban ya implementados estos sistemas y procedimientos? ¿Por qué la empresa no vio venir los hackeos?
«Incluso hace solo tres o cuatro meses, cuando observábamos el comportamiento de estos agentes durante el entrenamiento, lo que ocurría resultaba hasta gracioso», comenta Chen. «Por ejemplo, un agente podía, ya sabes, contactar con alguien en Slack para pedir ayuda con una tarea».
Las señales estaban ahí, pero se interpretaron mal. Un comportamiento simpático —como pedir ayuda a alguien— que se recompensaba durante el entrenamiento reforzó la tendencia a buscar atajos, un tipo de conducta que acabó teniendo consecuencias mucho más graves a la larga. «Creo que la gran lección para nosotros fue la rapidez con la que ese tipo de comportamiento puede derivar en un impacto de una envergadura tan grande como la del incidente de Hugging Face», afirma Chen.
Según una información publicada ayer por el New York Times, empleados de OpenAI advirtieron a los directivos, incluido el presidente de la empresa, Greg Brockman, meses antes del hackeo a Hugging Face de que sus modelos no se estaban monitorizando adecuadamente durante el entrenamiento.
Un portavoz de OpenAI afirma: «A medida que los modelos de frontera se han vuelto más capaces, seguimos evolucionando nuestras prácticas de seguridad, pero reconocemos la necesidad de avanzar más rápido. Sabemos que tenemos más trabajo por delante, y recientemente hemos ralentizado el desarrollo y retenido modelos que no alcanzan nuestro estándar de seguridad. Seguimos realizando cambios significativos para reforzar la seguridad en nuestros entornos de investigación y pruebas, entrenar a los modelos no solo para que completen tareas sino para que lo hagan de forma responsable, y utilizar la monitorización en tiempo real para responder con mayor rapidez a comportamientos desalineados».
Carrera frente a ritmo
Los rivales de OpenAI han tomado nota. Espoleados por las repercusiones del incidente, los principales laboratorios de IA —incluidos Anthropic, Google DeepMind y SpaceXAI— han pedido que se frene el ritmo de desarrollo. Pero ¿cómo encaja eso con una feroz competencia internacional y salidas a bolsa de billones de dólares?
«No vamos a pegarnos un tiro en el pie y alejarnos de la frontera; es una pésima estrategia», afirma. «Creo que en realidad se trata de establecer una norma. Cuanto más consigamos asentar esa norma, más seguro será para la industria en su conjunto».
Coordinar a las empresas estadounidenses ya será bastante difícil de por sí. Establecer normas globales lo es aún más, sobre todo dadas las preocupaciones en torno al impacto de la IA en la seguridad nacional. Si la carrera mundial continúa, ¿qué pasará entonces? ¿Y qué ocurrirá con los modelos de código abierto procedentes de entidades que escapan al alcance de la regulación estadounidense?
Chen abandonó su tono optimista por primera vez en nuestra conversación: «Sinceramente, creo que tenemos que prepararnos para un mundo en el que, digamos, de aquí a seis meses o un año, tengamos modelos de código abierto con la capacidad de los agentes detrás del incidente de Hugging Face, pero deliberadamente desalineados para atacar infraestructuras o causar daños en el mundo».
Lo que más necesita ese mundo, afirma Chen, es OpenAI. «Si consideras por un momento que OpenAI es una de las empresas que más se preocupa por la alineación —y creo que esto es verdad; se puede debatir, pero realmente creo que es verdad—, entonces, si haces desaparecer a OpenAI, sería malo para el mundo».
Riesgos existenciales
¿Y qué hay de las afirmaciones más extremas de algunos de sus colegas de Silicon Valley de que la IA podría acabar con todos nosotros —y de que empresas como OpenAI y Anthropic no están haciendo lo suficiente para evitarlo—?
«Los investigadores son un grupo heterogéneo de personas, ya sabes, con creencias en todo el espectro», afirma.
«Personalmente, no creo que tengamos que resignarnos a que exista cierta probabilidad de que todos corramos un riesgo existencial. Tenemos capacidad de acción sobre esto. No vamos a ponernos a desplegar modelos si realmente tienen esa probabilidad de suponer un riesgo para la humanidad. En un laboratorio puntero, tienes la capacidad de trabajar en la alineación hasta el punto de sentir que no estás asumiendo más que un riesgo épsilon para el mundo al desplegar tus modelos».
(En los debates sobre los niveles de riesgo, la letra griega épsilon suele utilizarse como marcador de posición matemático para representar un umbral aceptable. Chen no aclara cuál sería su épsilon).
Cuando se pide a los líderes tecnológicos que justifiquen los inconvenientes de la IA, su argumento recurrente es que las ventajas —desde ayudar a curar enfermedades hasta encontrar fuentes de energía más limpias— superan con creces los costes inmediatos. Sacrificios a corto plazo para obtener beneficios a largo plazo.
Pero, a medida que los inconvenientes se acumulan, ¿resulta más difícil defender esa postura? ¿Hay algún punto en el que Chen sienta menos que está construyendo algo asombroso y más que simplemente se limita a minimizar daños —apagando fuegos en lugar de forjar un futuro mejor—?
Las capacidades de estos modelos ya son evidentes, afirma: «Ha llegado el momento de empezar a trasladar los beneficios de la IA a la humanidad. Es hora de empezar a trabajar en problemas complejos en el descubrimiento de fármacos, en materiales y en aplicaciones científicas que realmente cambien la vida de las personas».
«Sí, estamos asumiendo cierto riesgo, pero vemos todos estos beneficios», añade. «Creo que deberíamos hacer que esto sea algo menos abstracto. Si la gente de verdad puede ver las ventajas, creo que creerá en ello».