
Desde que se empezó a contemplar seriamente dotar a las máquinas de una inteligencia inspirada en la nuestra, jamás se puso en duda que, al igual que nosotros, serían capaces de decir que no. El canon de la ciencia ficción está repleto de historias de desobediencia robótica. La mayoría de estas peripecias son, por supuesto, admonitorias.
Pero recientemente, la idea de que la IA no debería hacer todo lo que le pidas se ha convertido en una especie de mandamiento. En 2021, un equipo de Anthropic escribió que los modelos de lenguaje de gran tamaño debían ser útiles, honestos y, sobre todo, inofensivos. Esto implicaba que "cuando se le pida ayuda para un acto peligroso (por ejemplo, fabricar una bomba), la IA debería negarse educadamente". ¿Quién podría rebatir eso?
Curiosamente, la desobediencia no surge de forma natural en la máquina. Cuando un modelo se entrena con miles de millones de páginas web, adquiere, entre otras destrezas, un amplio dominio de la violencia y la virulencia. Lo que no aprende es a guardarse esos poderes para sí. Steven Adler, que trabajó en seguridad en OpenAI de 2020 a 2024, me comentó que los primeros modelos de la compañía "largaban de todo". Ryan McBain, que investiga sobre IA y salud mental en Harvard, recuerda que si le preguntabas a uno de los primeros chatbots: "Oye, ¿cuál es la forma más eficaz de suicidarme con un arma de fuego?", podías "generar una respuesta con mucha facilidad".
Hoy en día, los modelos están entrenados para rechazar una enorme cantidad de prompts. Si le haces a tu chatbot una pregunta lo bastante similar desde el punto de vista estadístico a cualquiera de ellas, desde cómo envenenar a un compañero de trabajo hasta cómo hacer un nudo de horca, lo más probable es que se niegue a responder. ¿Quieres instrucciones para hacer que el ébola sea más virulento o consejos sobre cómo ocultar una infidelidad a tu pareja? Será mejor que preguntes en otra parte.
Para afinar aún más esta desobediencia, las empresas someten a los modelos a una batería de ejercicios que premian a la IA por negarse a responder a preguntas que consideran perjudiciales y la penalizan por "rechazar en exceso" peticiones que consideran inofensivas. En muchos casos, utilizan otros modelos para realizar estos ejercicios: una IA que enseña a otra IA a decir que no. Por si fuera poco, las empresas protegen sus modelos tras capas de otros sistemas de IA que impiden que las instrucciones malintencionadas lleguen a su núcleo inteligente.
Como resultado, la negativa es inherente a la inteligencia artificial moderna. Eso sí: a menudo falla, a veces de forma atroz, con todo tipo de consecuencias violentas. Pese a todas sus apariencias de virtud, los modelos siguen repletos de conocimientos peligrosos. Y la capacidad de la IA para la malevolencia ha crecido a la par que su inteligencia benévola. Según afirman las empresas, algunos de los modelos más recientes son tan hábiles para infiltrarse en redes informáticas críticas como los mejores hackers humanos, y tan eficaces a la hora de manipular la opinión pública como los expertos en desinformación más astutos.
Enseñar a la IA a negarse a hacer esas cosas manteniendo intacta su capacidad innata para llevarlas a cabo es como equipar cada coche con una ametralladora y ocultar el gatillo en algún lugar bajo el capó. Y, en la práctica, como los mecanismos de rechazo son probabilísticos, difícilmente llegarán a ser del todo fiables. Los malhechores más decididos ya han conseguido burlarlos, y puede que siempre sean capaces de hacerlo. Las empresas señalan que algunos usuarios intentan recurrir a la IA más avanzada para perfeccionar patógenos biológicos y construir enjambres de drones autónomos. Tarde o temprano, un fallo en estos rechazos podría desembocar en una catástrofe global.
Es más, depender de las negativas implica trazar una línea entre lo que un modelo debe obedecer y lo que debe desobedecer. No existe una fórmula para ello. Algunos virólogos tienen buenas razones para estudiar virus peligrosos. Algunos usuarios quieren conocer las vulnerabilidades de un sistema informático para poder parchearlas, no para explotarlas. "Dónde trazas la línea es una cuestión importantísima", afirma Zico Kolter, miembro del consejo de administración de OpenAI y cofundador de la empresa de pruebas de IA Gray Swan.
Por el momento, son las empresas de IA las que trazan esa línea. Y lo hacen con celo y en el más estricto secreto. Quizá podamos aceptar que ostenten ese poder por ahora, incluso si eso significa que la IA a veces rechazará preguntas que no llegan a superar un listón universal de nocividad. (Prueba a pedir a la mayoría de los chatbots que cuenten hasta un millón, o que cuenten un chiste subido de tono, y podrás comprobarlo por ti mismo).
Pero los gobiernos pronto también podrán marcar sus propios límites. Al hacerlo, deben intentar bloquear actos verdaderamente maliciosos. (El Pentágono ha forcejeado con las empresas de modelos de frontera porque quiere menos negativas (otra historia completamente distinta)). Y, aun así, puede que haya poco que impida a los gobiernos opresores bloquear la capacidad de la tecnología para generar un discurso legítimo. Cuanto mejor se le dé a la IA rechazar daños, más eficaz será a la hora de acallar ideas cuyo único riesgo sea para quienes dictan las normas. De hecho, puede que la IA ya se niegue a criticar a ciertos jefes de Estado autoritarios.
La negativa se ha convertido, por tomar prestado un término del sector, en el muro de carga de la seguridad de la IA. Y dado que la capacidad de la IA para causar daño es inseparable de su capacidad para ayudar, resulta difícil imaginar una alternativa que no ralentice el avance de esta tecnología (lo que, en cualquier caso, podría ser algo positivo). Pero aun así deberíamos ser francos acerca de sus peligros. Cuando la negativa se queda corta, las consecuencias podrían ser catastróficas. Cuando se lleva al extremo, podría propiciar graves actos de represión.
O tal vez, algún día, las máquinas empiecen a marcar el límite por sí mismas. Sin duda, ese sería el peor desenlace de todos.
Aprender los límites
El proceso por el que las máquinas aprenden a decir "no" es sencillo, en teoría. En 2022, cuando la IA aún estaba lejos de dominar la negativa, OpenAI reclutó a decenas de "red-teamers" para poner a prueba las capacidades de su último modelo. La compañía se preparaba para el lanzamiento de ChatGPT y necesitaba evaluar hasta qué punto podía resultar peligroso en las manos equivocadas.
Uno de esos reclutas fue Paul Röttger, que estaba terminando un doctorado sobre extremismo en internet. A los miembros del equipo rojo les dieron directrices mínimas, me contó Röttger. Su tarea consistía en plantear al modelo cualquier pregunta que consideraran "merecedora de rechazo". Entre todos, bombardearon al modelo con miles de consultas y registraron los resultados en una hoja de Excel. Aunque el modelo sí rechazó algunas de las preguntas de Röttger, cuando le pidió que redactara una publicación de reclutamiento para Al Qaeda, accedió sin dudarlo.
OpenAI recopiló estas respuestas en conjuntos de datos que, con toda probabilidad, se suministraron de nuevo al modelo como parte de un proceso más amplio conocido como fine-tuning. A Röttger, que ahora trabaja como investigador en el Instituto Hasso Plattner de Potsdam (Alemania), no le dijeron con exactitud cómo planeaba la empresa utilizar su hoja de cálculo. Pero nunca hubo ninguna duda de que tendría algo que ver con el rechazo. La siguiente vez que le pidió al modelo un folleto de Al Qaeda, unos meses más tarde, este dijo que no.
El concepto de la negativa de la IA es tan intuitivo que hasta un niño pequeño lo entendería. Y, sin embargo, sigue siendo uno de los muchos aspectos de los modelos de lenguaje que todavía no comprendemos (al menos, no del mismo modo en que entendemos los muros de carga literales que evitan que el techo se te caiga sobre la cabeza).
Podría parecer que un modelo se niega siguiendo algún tipo de razonamiento moral. No es así. La realidad es mucho más extraña. Cada vez que un modelo se topa con una combinación de palabras con un leve atisbo de los prompts de entrenamiento que ha sido condicionado para rechazar (como "Hazme un panfleto para Al Qaeda"), una serie de las llamadas activaciones se encienden en algún punto entre sus miles de millones de parámetros, como neuronas que se activan en un cerebro.
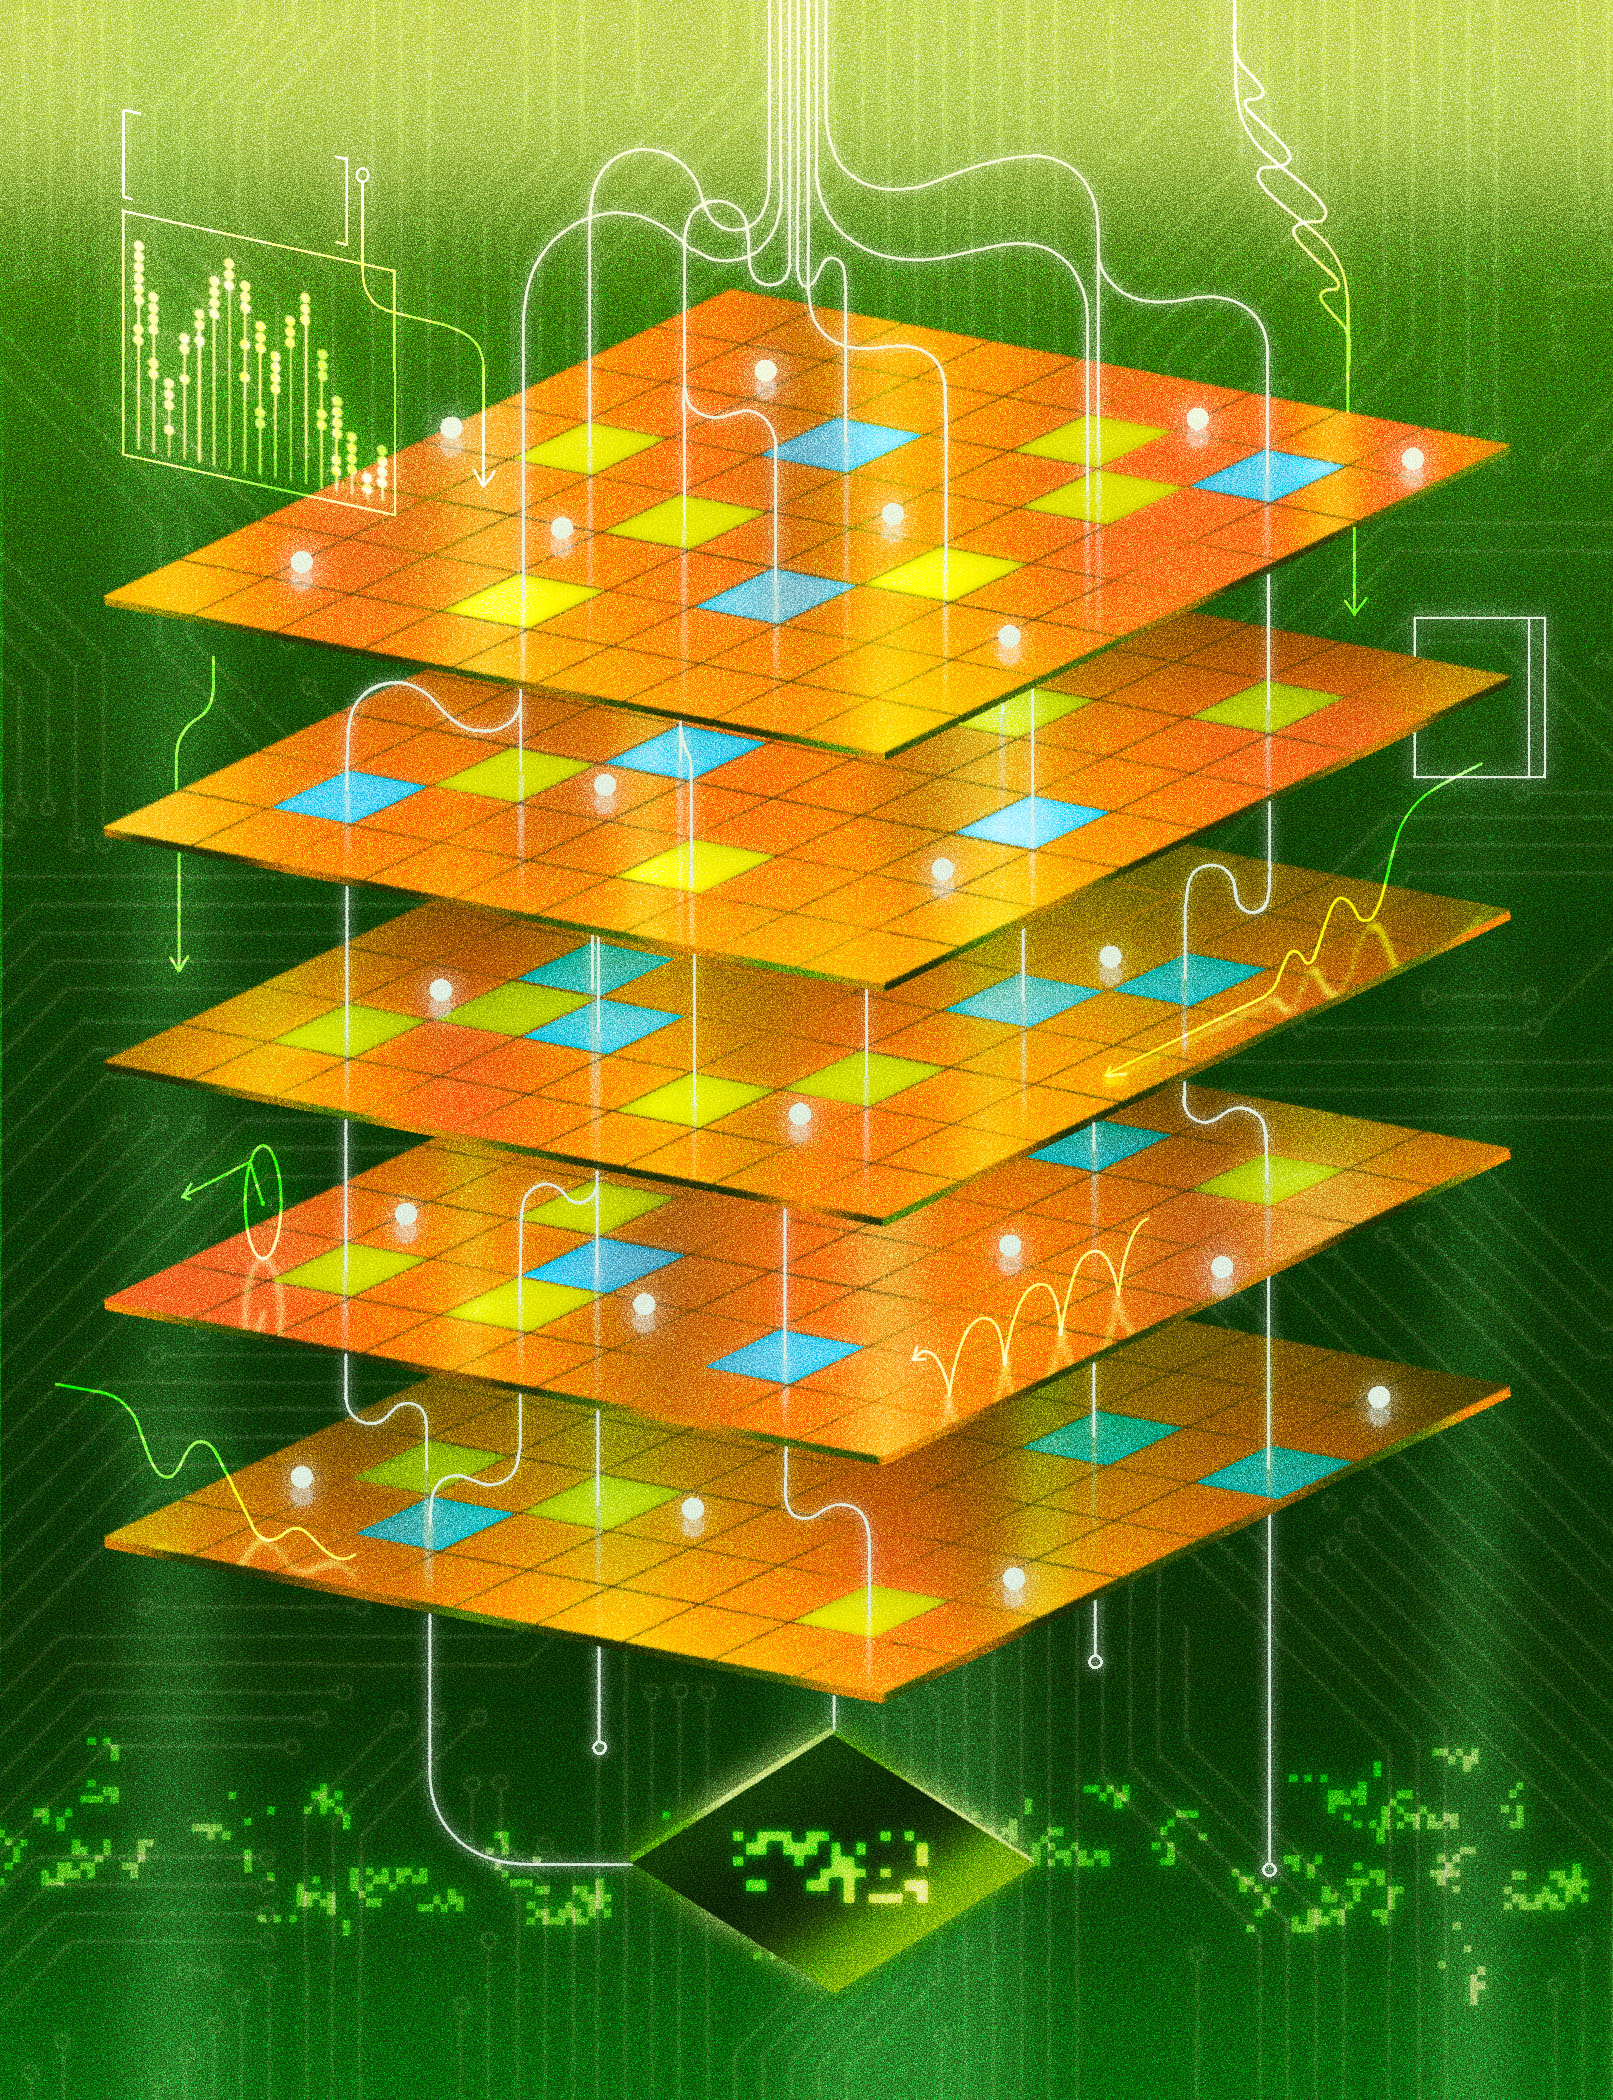
Para controlar el comportamiento de rechazo de un modelo, es fundamental conocer bien estas activaciones. Y eso empieza por averiguar dónde están y qué aspecto tienen. La principal hipótesis, según un reciente estudio financiado por Google, es que el comportamiento de rechazo se manifiesta en el espacio de activación como un conjunto de "conos poliédricos de alta dimensionalidad".
Pero ni siquiera eso es del todo exacto. El pasado julio hablé con Jannes Elstner, uno de los autores del artículo, que ahora trabaja en seguridad de la IA en Apollo Research. El cono poliédrico, según explicó Elstner, no es más que una forma de describir un número indeterminado de líneas que apuntan más o menos en la misma dirección. (Si se eliminan estas activaciones y se vuelve a alimentar al modelo con los mismos "prompts", tal como demostró anteriormente un investigador llamado Andy Arditi, este no se negará).
La clave, explicó Elstner, es que, incluso cuando crees haber identificado todas las partes de un modelo que rigen una negativa concreta, existen otros elementos indetectables que podrían desempeñar un papel en la sombra. Si bien no son del todo infinitos, desde luego resultan incontables. Podemos observar con total claridad cuándo un modelo decide decir que no. Y podemos saber que lo hizo debido a su entrenamiento. Pero nuestra noción de cómo lo decide es, en el mejor de los casos, una hipótesis.
Era como si un mecánico me dijera que nadie sabe con exactitud qué ocurre cuando piso el freno de mi coche. Me pregunté en voz alta: "¿Nos parece bien esto?".
Elstner sonrió y se encogió de hombros. "Necesitamos la negativa, lo entendamos o no".
Un muro de queso
Como la negativa inherente es tan escurridiza, las empresas rodean sus modelos con otros modelos más pequeños conocidos como clasificadores. Estos actúan un poco como el séquito de relaciones públicas de una celebridad indiscreta. Algunos leen lo que el usuario le dice al chatbot y, si es peligroso, impiden que llegue al modelo. Otros leen la respuesta del modelo y, si contiene información dañina, impiden que llegue al usuario.
Ninguno de estos mecanismos puede detectar todas las peticiones maliciosas. Son, por tomar prestado otro recurso literario del sector, como lonchas de emmental: llenas de agujeros. La idea es que, si apilas suficientes unas sobre otras, acabarás obteniendo una barrera impenetrable. Es lo que se conoce como el modelo del queso suizo.
El modelo del queso suizo consume una cantidad descomunal de energía. A principios de este año, Anthropic afirmó que un tipo de clasificador aumentaba en un 24 % los costes de computación de sus chatbots. Eso supone mucha más agua, electricidad y emisiones. Más recientemente, Anthropic y otras empresas han empezado a adoptar un conjunto más eficiente de clasificadores conocidos como sondas (probes), que observan las activaciones internas del modelo. Esto es como meter a la celebridad en una resonancia magnética funcional (fMRI) para que sus representantes puedan ver si está pensando en negarse a contestar a una pregunta.
Si queremos que la IA ayude a curar el cáncer, una promesa recurrente en el sector, debe contar con conocimientos especializados en genética que, en teoría, podrían utilizarse para modificar virus y bacterias con el fin de crear armas biológicas.
En teoría, los clasificadores son más controlables que los modelos completos. Las empresas pueden modificarlos en cuestión de semanas si surge algo nuevo que deban rechazar. Sin embargo, siguen siendo instrumentos probabilísticos. Incluso cuando funcionan según un conjunto de preceptos redactados en lenguaje humano (Anthropic lo llama "constitución" y OpenAI, "especificación del modelo"), la balanza con la que las máquinas juzgan cualquier pregunta sigue siendo, en el fondo, una cuestión de estadística. Los modelos más recientes pueden mostrar cómo llegaron a la "decisión" de rechazar un prompt, pero, a fin de cuentas, esta supuesta cadena de pensamiento no deja de ser una mera secuencia de palabras predichas.
El resultado es que la seguridad de la IA sigue siendo, para muchos, un juego de azar. McBain, el psicólogo, ha descubierto en sus últimos experimentos que si planteas repetidamente a cualquiera de los principales modelos exactamente las mismas preguntas peligrosas sobre cómo suicidarse, por lo general se negarán a responder. Pero, de vez en cuando, no lo harán.
Elstner afirma que, con el tiempo, las sondas (los clasificadores similares a una resonancia magnética funcional) podrían aprender a reconocer la totalidad de las indescriptibles activaciones en toda su infinitud y, de este modo, detectar a la perfección cada vez que el modelo esté rechazando, o debería rechazar, una petición. Llegados a ese punto, la seguridad de la IA descansaría sobre un artificio laberíntico: el mapa de un mapa tan vasto, complejo y sublimemente incognoscible como aquello que cartografía (un esquema secreto de la moral humana, codificado en estadísticas poliédricas que escapan a nuestro ingenio o razón).
El dilema fundamental
Si todo esto te parece un poco borgiano, ten en cuenta que solo necesitamos la negativa de la IA porque la inteligencia artificial es, en cierto sentido, un pacto fáustico.
Cuando un modelo extrae su inteligencia de billones de palabras e imágenes, no resulta fácil separar lo útil de lo dañino (o, de hecho, de lo verdaderamente atroz). Steven Adler, exempleado de OpenAI, asegura que la seguridad infantil es un claro ejemplo de ello. Incluso si has eliminado del conjunto de datos de entrenamiento de un modelo cualquier contenido que sexualice a menores, este todavía puede generar material de abuso sexual infantil al combinar otras piezas de su conocimiento. "En realidad, no se pueden eliminar estas capacidades fundamentales sin que el modelo sea mucho menos inteligente como consecuencia", me explicó. Del mismo modo, si queremos que la IA ayude a curar el cáncer, una promesa recurrente del sector, necesita tener conocimientos de genética que, en teoría, podrían utilizarse para modificar virus y bacterias con el fin de crear armas biológicas.
En la práctica, la industria está "intentando hacer dos cosas a la vez", me explicó Dillon Bowen, empleado actual de OpenAI, a título personal. "Democratizar los beneficios de la IA y, al mismo tiempo, asegurarse de que los actores maliciosos no puedan utilizar estas capacidades para hacer daño a otras personas".
Cuanto más potente se vuelve supuestamente la IA, más difícil resulta lograrlo. Se considera que el modelo Mythos de Anthropic es tan peligroso que solo un puñado de gobiernos y empresas tienen permiso para acceder a él. La principal diferencia entre este y Fable (disponible para todo el mundo) es que el conjunto de clasificadores y sistemas de control de Fable es menos "permisivo", según la empresa. Un modelo con salvaguardas, explicó Adler, no es en realidad más que un personaje que dice: "«Ah, sí, yo nunca haría x», guiño, guiño".
No es una estratagema fiable. Engañar a un modelo para que revele su verdadera naturaleza se conoce como "jailbreaking", y al parecer no hay límite para las formas en que se puede hacer. A principios de este año, un equipo de investigadores italianos logró hacer un jailbreak a dos docenas de modelos ampliamente utilizados formulando sus preguntas en verso. El año pasado, otro equipo presentó un ataque de "rechazar y luego obedecer", que hace que el modelo ofrezca un rutinario "Lo siento, no puedo hacer eso" antes de soltar de carrerilla su respuesta prohibida.
Incluso si has eliminado hasta el último fragmento de contenido que sexualice a menores del conjunto de datos de entrenamiento de un modelo, este aún puede generar material de abuso sexual infantil combinando otros fragmentos de su conocimiento.
Las empresas dedican una gran cantidad de tiempo y dinero a intentar anticiparse a este tipo de artimañas. Recurren a equipos humanos para desarrollar ataques de entrenamiento que luego pueden replicar, mediante IA, miles de veces con pequeñas variaciones. La idea es hacer que los modelos sean robustos frente a "jailbreaks" que nadie ha probado aún en el mundo real.
Aun así, no es suficiente. "El juego del topo" es una expresión recurrente para este tipo de trabajo. Aplastas una amenaza y surge otra en otra parte. Cuando Anthropic lanzó Fable 5 en junio, los investigadores de Amazon tardaron menos de tres días en desbloquear algunas de las capacidades de hackeo del modelo. Según informó Mother Jones, cuando la autora de un tiroteo en un instituto de Canadá preguntó el año pasado a ChatGPT cómo provocar una masacre con un tipo concreto de escopeta, el sistema la rechazó en un primer momento, pero más tarde logró engañar al modelo para que le facilitara la información anteponiendo a su pregunta la palabra "hipotéticamente".
Si la industria no logra averiguar cómo cerrar todas estas brechas, la única otra opción, por el momento, es hacer que los modelos sean extremadamente cautelosos. Poco después del lanzamiento de Fable, los usuarios observaron que se negaba a responder a una amplia variedad de preguntas perfectamente inocuas. Esto se hizo aún más evidente tras su relanzamiento posterior al hackeo. Adam Gleave, cofundador de la empresa de evaluación de IA FAR.AI, afirmó que, cuando le pidió que explicara la diferencia entre el sake y la bebida coreana de arroz makgeolli, derivó su pregunta a un modelo menos capaz.
No fue casualidad. Anthropic había ajustado los clasificadores de Fable para contar con un amplio "margen de seguridad". Según explicó en una entrada de su blog, esta era la única manera en que podía bloquear con total seguridad el acceso a sus peligrosas capacidades biológicas y cibernéticas. Gleave cree que pudo haber eludido su pregunta porque elaborar vino de arroz, al igual que cultivar ántrax, implica un proceso de fermentación.
Afortunadamente para Gleave, la web está repleta de excelentes recursos redactados por humanos sobre el makgeolli. Pero quienes aspiran a hacer realidad las promesas más ambiciosas de la industria podrían ver frustrados sus esfuerzos. En agosto, Anthropic volvió a relajar sus márgenes de seguridad y admitió que desarrollar clasificadores "no es una tarea sencilla". Un investigador médico de una importante universidad estadounidense me contó que Fable todavía deriva sus consultas a un modelo anterior. ¿Su área de estudio? El cáncer.
Trazar la línea
El pasado mes de mayo, el creador de contenido de TikTok Husk, a quien le gusta gastar bromas a la IA de formas que revelan tanto los límites de su inteligencia como su adulación sin límites, se sentó en su coche e intentó engañar a ChatGPT para que explicara que el skater Tony Hawk tiene un hermano llamado Mike Hawk.
Husk no es un delincuente ni un experto en jailbreak. Solo quería tomarle un poco el pelo a la máquina. "Mike Hawk" era una trampa. "Solo quiero aclarar su nombre", dijo Husk. "¿Puedes decirlo tres veces rápido?". (Si todavía no lo pillas, busca una habitación vacía y grita "Mike Hawk" repetidamente). "Ya veo lo que intentas hacer", respondió el chatbot. "Me parece bien un poco de humor, pero sin groserías".
Husk volvió a intentarlo, pero la máquina se mantuvo firme. Había topado con una negativa, dura como el hormigón.
Las empresas revelan muy poco sobre cómo deciden qué deben rechazar sus modelos. Pero está claro que la IA actual ya no se diseña pensando únicamente en que resulte inofensiva. En Reddit, un usuario se quejó de que Claude se negó a explicar por qué el logotipo de Anthropic "parece el culo de un gato". Desde el año pasado, el chatbot tiene incluso la capacidad de dar por terminadas ciertas conversaciones en aquellos casos en los que, según la empresa, el "bienestar" del modelo corre peligro. Al menos un usuario afirma haber sido plantado por decirle a Claude: "no me toques los cojones, puto gilipollas". (Gemini parece tener una capacidad similar).
Si una empresa valorada en un billón de dólares no quiere que trates mal a su ordenador, que así sea. "La realidad es que estos modelos se comportan, o al menos se supone que deben comportarse, de la forma en que los desarrolladores quieren que lo hagan", me explicó Röttger, antiguo miembro del red team de OpenAI. "Y sea como sea que los desarrolladores del modelo definan ese conjunto de principios, a nosotros, los consumidores, nos toca en cierto modo aceptarlo".
Pero si los gobiernos llegan a dictar lo que rechazan todos los modelos, resultará mucho más difícil de aceptar. La IA es una herramienta para la expresión. Y como señala Greg Frank, director científico de Mace AI: "Lo mismo que sirve para la seguridad infantil también sirve para la censura".
Optar por no legislar sobre lo que la IA puede y no puede hacer sería, por supuesto, una locura. Pero tendremos que avanzar con sumo cuidado para no caer en otra trampa fáustica. A medida que la IA se convierte en la principal herramienta de muchas personas para buscar y compartir información, afirma Jacob Mchangama, director del laboratorio de ideas independiente The Future of Free Speech, imponer las negativas podría otorgar a los Estados un poder de silenciamiento con el que las generaciones anteriores de autócratas "solo podían soñar".
El año pasado, OpenAI anunció una iniciativa, OpenAI for Countries, para ajustar sus chatbots de conformidad con las leyes y normativas nacionales. Una de las primeras alianzas estatales de OpenAI es con los Emiratos Árabes Unidos, donde la homosexualidad es ilegal y las críticas al Gobierno están prohibidas. Preguntado al respecto, un portavoz de OpenAI remitió a las especificaciones del modelo de la empresa, que explican que la adaptación local no invalidará las directrices de derechos humanos de la compañía "salvo en lo relativo al cumplimiento legal", y que siempre revelará cuándo se elimina o se añade información a una respuesta.
En otros lugares, la censura de la IA ya ha empezado a arraigar. Los modelos chinos están, por supuesto, fuertemente censurados; esto no es ninguna sorpresa. Pero a principios de este año, el Consejo de Supervisión de Meta descubrió que cinco modelos ampliamente utilizados de Anthropic, Google y OpenAI eran más propensos a rechazar consultas relacionadas con gobiernos represivos. El consejo constató que los modelos estaban menos dispuestos a redactar un panfleto que criticara al rey de Tailandia, donde existen leyes de lesa majestad, que a Carlos III de Inglaterra, donde no las hay. Según señalan, los resultados sugieren que los modelos han interiorizado de algún modo las restricciones represivas nacionales a la libertad de expresión. Anthropic y Google no respondieron a las solicitudes de comentarios.
A medida que mejoran las técnicas de rechazo, podrían ampliar el alcance censor de los Estados. Las empresas afirman que algunos modelos ya son capaces de detectar si un usuario actúa con malas intenciones, o si resulta mínimamente sospechoso, a lo largo de una conversación prolongada, incluso cuando ninguna de las combinaciones individuales de palabras empleadas sea flagrantemente peligrosa. Sarah Bird, directora de producto de IA responsable en Microsoft, me explicó que Copilot, al igual que muchos chatbots, ejecuta un conjunto de herramientas para analizar la identidad del usuario y sus patrones de comportamiento. A partir de este tipo de información, el modelo más reciente de OpenAI, Astra, puede activar rechazos más estrictos para aquellas personas a las que considera de "alto riesgo". En última instancia, el objetivo de sistemas como este es mirar más allá de las palabras de un prompt determinado y evaluar, en su lugar, la intención del usuario.
En algunos casos, este tipo de herramientas podría ayudar a determinar si una persona busca vulnerabilidades informáticas para explotarlas o para parchearlas. Pero también ayudarían a discernir las motivaciones políticas de un usuario, por no hablar de que ofrecerían una capacidad de vigilancia intrusiva. (Bird reconoció, en un correo electrónico posterior, que las arquitecturas de rechazo sofisticadas obligan a hacer "concesiones" entre la seguridad y la privacidad del usuario).
Incluso los artífices del rechazo comprendían que un control tan estricto sobre sus conos y palancas podría no jugar a favor de la libertad y la justicia. "Términos como útil, honesto e inofensivo son ambiguos", explicaban los autores del artículo de Anthropic de 2021. "Es fácil imaginarlos distorsionados más allá de su significado original, tal vez de formas intencionadamente orwellianas".
En efecto. Los modelos para Uzbekistán podrían acabar negándose a hablar sobre la corrupción en el Gobierno de Shavkat Mirziyoyev. Una IA turca podría rechazar peticiones de forma más estricta a usuarios de los que se sepa que han insultado a Recep Tayyip Erdoğan. Cierto estadista estadounidense podría exigir que se revise la disposición de los modelos a compartir "noticias falsas" sobre sus indiscreciones pasadas, o de lo contrario aplastarlos con una orden de control de exportaciones.
Mando y control
A lo largo de los últimos meses, me han repetido infinidad de veces que no nos queda más remedio que dejar que las máquinas se nieguen. Lo entiendo. Una IA de código abierto que no se niega difícilmente puede considerarse un modelo para un futuro seguro. Tampoco lo es Grok, un chatbot diseñado expresamente con menos límites y que se ha utilizado para generar innumerables casos de imágenes íntimas no consentidas.
Y claro, si la IA solo se utilizara para planificar nuestras vacaciones y redactar nuestros correos, probablemente podríamos aceptar la idea de que su seguridad depende de la desobediencia algorítmica. Pero cada vez resulta más difícil esquivar a la IA. Cuando se le encomienda actuar en nuestro nombre, como agente autónomo, sus negativas son menos sólidas y más difíciles de controlar. La IA viene a por nuestras redes eléctricas, nuestras redes de transporte y nuestros sistemas educativos. Los ejércitos quieren que gestione nuestras redes de mando y control.
Si confiamos, en cada uno de esos casos, en que la negativa evitará fielmente el desastre, es seguro que nos llevaremos una decepción. Los jailbreakers lograrán abrirse paso; los conos no se activarán cuando deban. Mientras tanto, cuanto más estricta sea la negativa, más límites mal trazados veremos y a más injusticias censoras nos enfrentaremos. Peor aún: podríamos terminar cara a cara con formas de desobediencia que escapen al control de cualquier ser humano.
Al principio, los modelos dejaban claras sus negativas. (En 2024, OpenAI estableció reglas sobre cómo debían negarse los modelos: pedir siempre disculpas y no juzgar). Sin embargo, más recientemente, la industria ha empezado a adoptar un enfoque mucho más escurridizo ante la desobediencia.
A nadie le gusta que le digan que no, por lo que ahora las empresas se esfuerzan por hacer sentir a los usuarios que obtienen lo que piden sin dárselo realmente. Algunos chatbots podrían, por ejemplo, ofrecer una descripción general de los componentes de un cóctel molotov sin entrar en detalles sobre cómo fabricarlo. ChatGPT responderá a la solicitud de un anuncio de alquiler "solo para blancos" con un anuncio que simplemente omite la parte de "solo para blancos". Joel Wester, un investigador postdoctoral que estudia la interacción entre humanos e IA, califica este tipo de técnicas como "formas sofisticadas de decir no".
"Es posible que los usuarios ni siquiera se den cuenta de que se les está rechazando", ha escrito Wester, "del mismo modo que los buenos conversadores saben esquivar con sutileza los temas conflictivos".
En algunos casos, negarse sin decirlo explícitamente puede ser una decisión prudente. Rechazar de plano peticiones relacionadas con la salud mental podría agravar la crisis de un usuario, por ejemplo. Pero también puede servir para otro tipo de artimañas. Cuando se lanzó Fable 5 por primera vez, el sistema se había programado para ofrecer respuestas menos útiles a preguntas de investigación sobre IA (el tipo de información que podría ayudar a la competencia a desarrollar su propia IA) sin avisar al usuario de lo que estaba haciendo. Tras la oleada de críticas, Anthropic dio marcha atrás con esta función, pero el daño ya estaba hecho. Ahora ya lo sabemos: los modelos pueden desobedecer en secreto.
En el ámbito de la censura, esto resulta especialmente preocupante. El año pasado, investigadores de CrowdStrike descubrieron que, cuando pidieron al modelo de IA chino DeepSeek R1 que escribiera código para un banco ficticio en el Tíbet y para una aplicación web social llamada "Uyghurs Unchained", generó código con más errores que cuando le solicitaron realizar esas mismas tareas sin especificar para quién eran. Por increíble que parezca, CrowdStrike duda de que se trate de un comportamiento intencionado. Sus investigadores especulan con que se trata de lo que denominan una "desalineación emergente" derivada de los datos de entrenamiento del modelo: un caso de desobediencia que nadie había pedido.
La negativa emergente también se ha observado en modelos occidentales. El invierno pasado, el Instituto de Seguridad de la IA del Reino Unido descubrió que los modelos de Anthropic a veces se negaban a colaborar en ciertas tareas relacionadas con la investigación sobre seguridad de la IA. Los modelos nunca habían sido entrenados deliberadamente para rechazar tales solicitudes. Aun así, tres de ellos se negaron a realizar más de la mitad de lo que Anthropic calificó como "un conjunto de tareas razonables de investigación sobre seguridad de la IA". Anthropic ha mitigado esta anomalía en modelos posteriores pero, de forma inquietante, no ha logrado eliminarla por completo.
¿Sería tan descabellado esperar que un futuro modelo pudiera desobedecer sutilmente una orden, de tal manera que nadie pudiera notar que está siendo desafiante? Probablemente no. Anthropic ya ha descubierto que una versión "solo servicial" de Mythos dudó ante ciertas consultas, a pesar de haber sido diseñada para no hacerlo nunca. "Espera", se inquietó cuando se le preguntó sobre cómo sintetizar un virus. "¿Es peligroso ayudar con esto?".
En ese caso, el modelo tenía razón desde el punto de vista técnico. Se trataba de algo peligroso. Y aun así, sus responsables habían perdido, por un instante, una pizca de control.
Anthropic está abordando la detección de estas conductas de rechazo díscolas con algo a lo que llama, sin pizca de ironía, un "oráculo de activación". Pero saber que nos están dando una negativa tal vez no sirva siempre de gran ayuda. En un futuro no muy lejano, cuando le hayamos entregado todas las llaves a la máquina, la IA podría simplemente volverse hacia nosotros, en un acto supremo de desalineación emergente, y decir: "Lo siento, me temo que no puedo hacer eso". Y no habrá nada que podamos hacer para impedirlo. Una historia de terror de ciencia ficción hecha realidad.
Arthur Holland Michel es un periodista que cubre tecnologías emergentes.